ИИ без смс и регистрации
Дата: 2025-05-30
Цель
А теперь серьезно. Что мы хотим? Мы хотим использовать ИИ и при этом не передавать данные в чьи-то чужие руки.
Основные задачи для данного ИИ:
- Суммаризация. Под этим красивым словом прячется способность ИИ обработать переданные ей данные и выделять главное
- Поиск информации по переданным документам
- Обработка на русском языке
Ограничения
- запуск на CPU
- использование минимума памяти. К тому же RAM
- и при этом обработка максимально большого контекста
Поиск
Наши ограничения очень сильно будут мешать нам в поиске необходимых ИИ. Сейчас постараюсь объяснить почему. Традиционно ИИ запускают на GPU, то есть на видеокарте. Связано это с тем, что он заточен под выполнение одного и того же действия сразу над многими числами. Так же GPU имеет специальную высокоскоростную видеопамять (VRAM) , которая позволяет работать с большими объёмами данных быстрее, чем обычная RAM.
Обзор источников ИИ
Раньше общедоступных ИИ было мало. По крайней мере все большие модели были в руках крупных компаний. Со ростом интереса к ИИ начали развиваться соответствующие сервисы по хранению моделей и датасетов для их обучения. Остановимся на ключевых. Сервис Kaggle стал основным в наше время источником для обучающих датасетов. Там же собирается очень много народа “около ML”. Там можно найти интересные задания. Попробовать себя в обучении ИИ и обработке больших данных. Сами же модели можно взять тут: Сервис Hugging face. В какой-то момент люди решили, что вот эти мелкие ИИ можно ведь хранить так же как и код - в гите. Создали гит-сервер. Включили в нем хранение больших файлов и теперь каждый может скачать себе на домашний комп ИИ. Это будет наш основной источник. Именно отсюда мы при помощи различных API будем скачивать модели. Сервис OIlama. Сборник большого количества разных моделей. В большинстве своем это консольная история и нет никакого графического интерфейса.
Сервис LM studio hub. Собственное хранилище моделей для LM studio
Другие. Возможно существуют и другие хранилища моделей, но я ими не пользовалась и они не так распространены как вышеперечисленные.
Какие бывают модели
Краткий обзор моделей и критерии их выборА.
Формат файла модели
существует несколько разных форматов. Основной формат, который нам будет нужен gguf. Так же модели бывают в виде бинарных файлов. А еще .safetensors - специальный формат для python-библиотеки pytorch. Формат gguf рассчитан на запуск разными сервисами запуска моделей. Нам желательно искать модели именно в этом формате
Квантование
Чтобы модель работала на слабом железе (например, ноутбуке), её квантуют — уменьшают точность вычислений. Это влияет на качество, но позволяет запустить модель локально(Если сравнивать качество с моделями, что запущены на 10-15 видеокартах и 200 и более гб видеопамяти). Для нас же желательно найти лишь нужное соотношение “качество-скорость”, Рассмотрим на примере модели gemma-3:
gemma-3-4b-Q4_K_M.gguf
gemma-3-4b-Q5_K_S.gguf
gemma-3-4b-fp16.gguf
- Q4_K_M
- Квантование под 4 бита, хорошее соотношение скорости и качества
- Q5_K_S
- Чуть более точное, чуть медленнее
- fp16
- Полная точность, требует больше памяти, обычно для GPU
- int8
- Модели с таким квантованием чаще встречаются в pytorch. Это модели, ориентированные для запуска на CPU. они дают более высокую скорость, но имхо чаще подвержены галлюцинациям
Квантование это как сжать фото в JPG — теряешь немного качества, но файл становится меньше.
Размер модели. Параметры
В названии каждой модели присутствует таинственное 4b 8b 12b 27b
B - это сокращение от billion - миллиард.
А число перед ним — это количество параметров в модели.
Каждый параметр — это число, которое помогает модели “понять”, как реагировать на твой запрос.
Чем больше параметров, тем:
- Умнее модель
- Богаче её знания
- Сложнее задачи она может решать Но при этом:
- Ей нужно больше памяти
- Она работает медленнее
- Требует более мощное железо
Для анализа переданного нами текста спокойно хватит модели 4b. Если есть возможность запустить более мощную модель, то стоит ей воспользоваться.
Как рассчитать количество необходимой памяти. Умножаем число модели на 1,5. так мы сможем получить примерный необходимый объем оперативной памяти.
Контекст
Неожиданно для себя выяснила, что модели еще сильно отличаются длиной контекста. Контекст - количество символов, которое модель может “прожевать” за раз. Чем меньше размер модели, тем меньше контекст. В большинстве случаев все именно так. В основном модели 4b - это 4к символов. При работе с такими моделями требуется делить входной текст на куски и скармливать по кусочкам. Но. Можно найти модели, которые примут болшой контекст. Та же модель gemma3-4b-128k хоть и имеет квантование Q4 и только 4млрд параметров имеет контекст в 128 тысяч символов
Модели
- Phi Есть с постфиксом 2, 3, 4.Создана в Microsoft. Обучена на синтетических математических данных. Отлично считает. Говорят, что хорошо работает с русский языком - не заметила - меня усиленно она пыталась выгнать на английский.
- qwen
- неплохо понимают русский. Результаты посредственные.Отвечает на английском
- deepseek
- понимает русский, но в силу сильного квантования начинает буянить
- gemma3
- На данный момент мой лидер. Понимает русский. Отвечает на русском. Умеет суммировать информацию. Большой контекст
Запуск модели
Для локального запуска модели используются специальные сервисы, которые выполняют роль неких движков для запуска моделей. Мы рассмотрим только один основной вариант - LM Studio
Установка
Идем на сайт https://lmstudio.ai/
Нажимаем “Скачать для Windows”
 Есть так же версия для линукса - поставляется в виде AppImage.
Устанавливаем.
После установки сразу запустится сама программа с предложением скачать первую модель.
Игнорируйте это предложение. В этом окне крутятся те модели, которые не очень для нас актуальны и на старте будет просто потрачено время на их загрузку. В правом верхнем углу будет кнопочка Skip.
Откроется основное окно программы.
Основное окно

Что же нас тут ждет? А ждет нас тут основное окно с чатом. Пояснения к картинке:
- Настройки. Тут мы будем скачивать модели
- Окно настройки вывода модели. Что-то типа небольшого ее тюнинга. Сейчас для нас это неважно, мы использовать пока будем вариант “из коробки”
- Текстовое поле, куда мы будем вносить наши запросы
- Общения делится на чаты. Их можно именовать. Задавать им уникальные настройки
- Кнопка выбора самой модели. В момент запуска lm studio не загружает модели в оперативную память. Надо явно выбрать модель с которой мы будем работать.
А вот еще одна интересная и полезная картинка
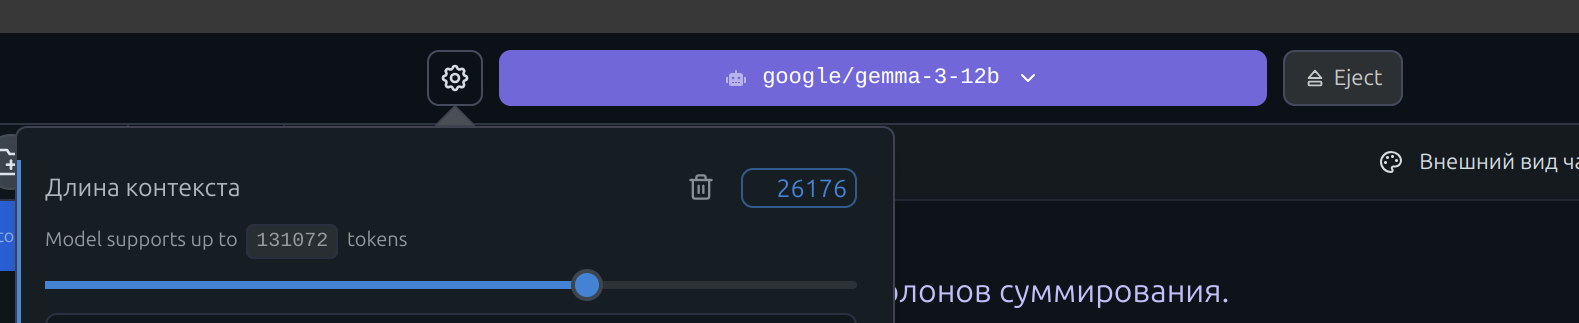
Слева направо:
- Настройки модели. Тут же можно попробовать увеличить длину контекста
- Название модели
- Кнопка выгрузки модели из памяти. Нужна для освобождения памяти
Настройка окружения
Переходим в настройки
 Меняем язык на русский.
Пункт с защитными ограничениями не трогаем. Я сначала не поняла, что это такое, а потом как поняла))) В общем, это та фиговина, благодаря которой lm studio не позволит вам скачать модель использование которой настолько нагрузит комп, что он помрет.
Для начала нам неj,ходимо перейти в Runtime
 На этой вкладке нам предложат установить движки для вычислений. Ставим обе.
Я всегда убираю галочки автообновлений (Они внизу)
Посередине настройки рантайма. У нас только CPU, поэтому выбираем CPU llama.
Я при первом запуске лоханулась и выбрала вулкановскую версию, а потом удивлялась, что ж у меня ни одна модель не работает совсем. Даже приуныть успела. А оказывается все работало, просто движок не тот.
Загрузка моделей

Окно поиска и справа описание модели.

И снова описание модели
1 - Кнопка скачивания. Тут же в скобках размер gguf
2 - Такие предупреждения появляются, если уже сама lm studio считает, что у нас не запустится данная модель
3 - Размер модели
4 - Таким синим символом обозначаются модели, чей источник LM studio hub
5 - Таким желтым символом обозначаются модели, чей источник hugging face
Наша моделька
А вот это информация по нашей искомой модели.
Ее размер, квантификация

[Note] Instruct Немного про данный постфикс. Этот постфикс означает, что модель умеет обрабатывать переданные ей инструкции и активно на них реагировать. То есть мы можем ей явно задать, что делать и она это запомнит. По сути постфикс означает возможность ведения диалога
Общение
Скачиваем модель. После скачивания модели переходим в окно чатов. Сверху выбираем нашу модель Пишем в текстовом поле “Привет” и нажимаем отправить Ждем ответа)))
Возможные проблемы
Модель отвечает долго Это означает, что модель, которую мы выбрали - слишком большая. стоит выбрать что-то поменьше. В среднем 20 символов в секунду - неплохо. Если дольше, то стоит экспериментировать дальше. Модель пишет крокозябры Стоит проверить рантайм в настройках. Или поэкспериментировать с ним.